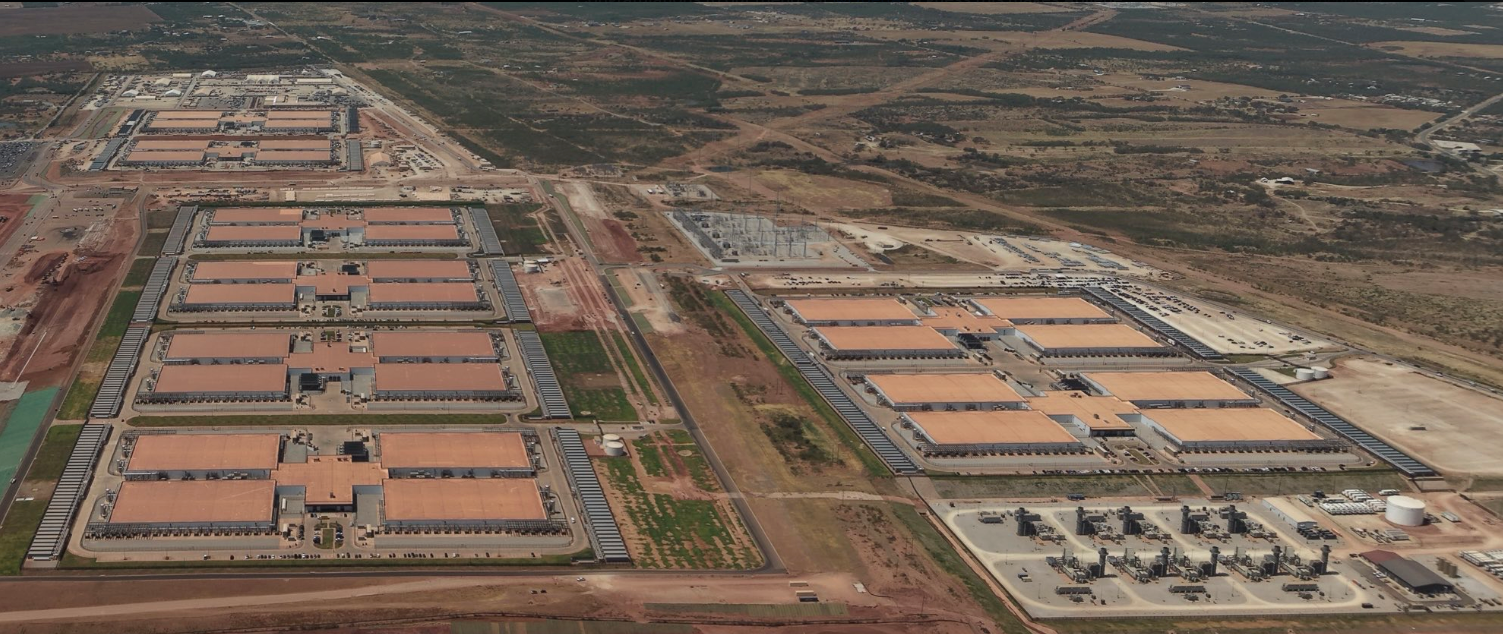
图 1:Chase 原帖配图。可以辨认重复的四翼建筑、沿建筑外侧布置的设备带,以及右下角的独立能源设施。图片出处。
从 Abilene 的卫星影像、建筑图纸和机柜规格,推演一场前沿模型训练。机房资料截至 2026 年 9 月 8 日,推理经济账与参数推演更新至 9 月 10 日。
Jensen Huang 最近给出了一个少见的硬件数字:
GPT-6 Astra, trained on ~100K+ NVIDIA Grace Blackwell NVLink72.
在同一条回复的结尾,他又写道:
400K GPUs coming online next.
这条推文发布于北京时间 9 月 7 日凌晨,回复的是 Crusoe 联合创始人 Chase Lochmiller。Chase 的原帖配了一张 Abilene 园区照片,将这里与 GPT-6 Astra 联系起来。Jensen 原帖 · Chase 原帖及配图
十万张 Blackwell,究竟是一座怎样的工厂?需要多少栋楼、多少电力,能够持续完成多少计算?再往前推一步,这些计算可能对应一个多大的模型?
我想从地面上看得见的东西出发,一层层走到模型里。
本文的中心猜测是:约 350B 活跃参数、10T 总参数、300T 累计主预训练 token。 B 为十亿,T 为万亿:每个 token 动用约 3500 亿参数,完整模型则拥有约 10 万亿参数。
这组数字沿着三条线索展开:机房与硬件界定资源规模,推理经济性帮助选择活跃参数,再用训练预算和开放 MoE 模型的数据配方推演总参数。十万卡提供起点,后面的每一步都需要明确的工程假设。
1. Abilene:从园区建设到模型训练
Abilene 是美国得克萨斯州的一座城市。这里的 Stargate 园区,也经常以 Lancium Clean Campus、Crusoe Abilene 或 Oracle/OpenAI Abilene 的名字出现。几个名字分别指向能源接入、基础设施开发,以及最终使用算力的不同环节。
Oracle 公布的园区信息是:八栋数据中心,占地约 1,100 英亩,总建筑面积约 400 万平方英尺。换成公制,大约是 4.45 平方公里的园区、37 万平方米的建筑。Oracle 园区资料
在 Abilene,从能源接入到 OpenAI 使用算力,各个环节由这些参与方共同完成:
| 环节 | 主要参与方 | 在这座园区里的角色 |
|---|---|---|
| 场地、能源与电网接入 | Lancium | 提供园区及能源基础条件 |
| 数据中心开发与融资 | Crusoe、Blue Owl、Primary Digital Infrastructure | 建设并持有基础设施,组织开发资金 |
| 建筑施工 | DPR 等承包商 | 将设计落成建筑与机电系统 |
| GPU 系统、网络与云服务 | NVIDIA、Oracle OCI | 提供计算平台,并将设备组织成可交付的云集群 |
| 训练与推理使用 | OpenAI | 使用算力训练模型、运行产品 |
来源:Crusoe 合资及扩建公告、DPR 项目介绍、OpenAI 对 Abilene 的介绍。
卫星影像与交付节奏
Epoch 的卫星查看器提供了比旧版 Google Earth 更新的观察窗口。同一范围的两张图,可以直观看到建设进展。
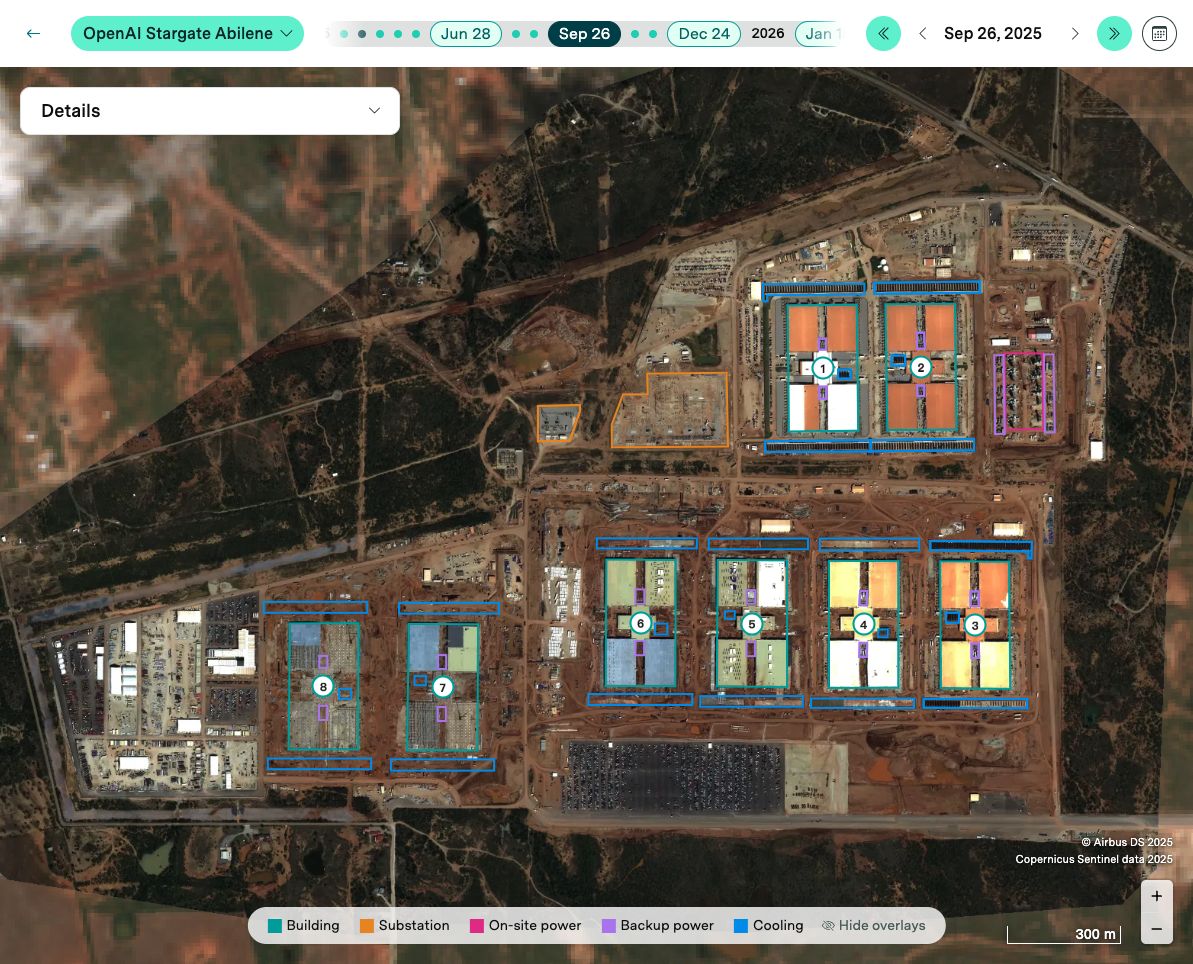
图 2:查看器日期为 2025 年 9 月 26 日。右上方前两栋已有完整屋顶,后续建筑仍处于不同建设阶段。编号与轮廓来自 Epoch;高分辨率影像署名 Airbus DS,截图保留原图标识。打开这一日期。
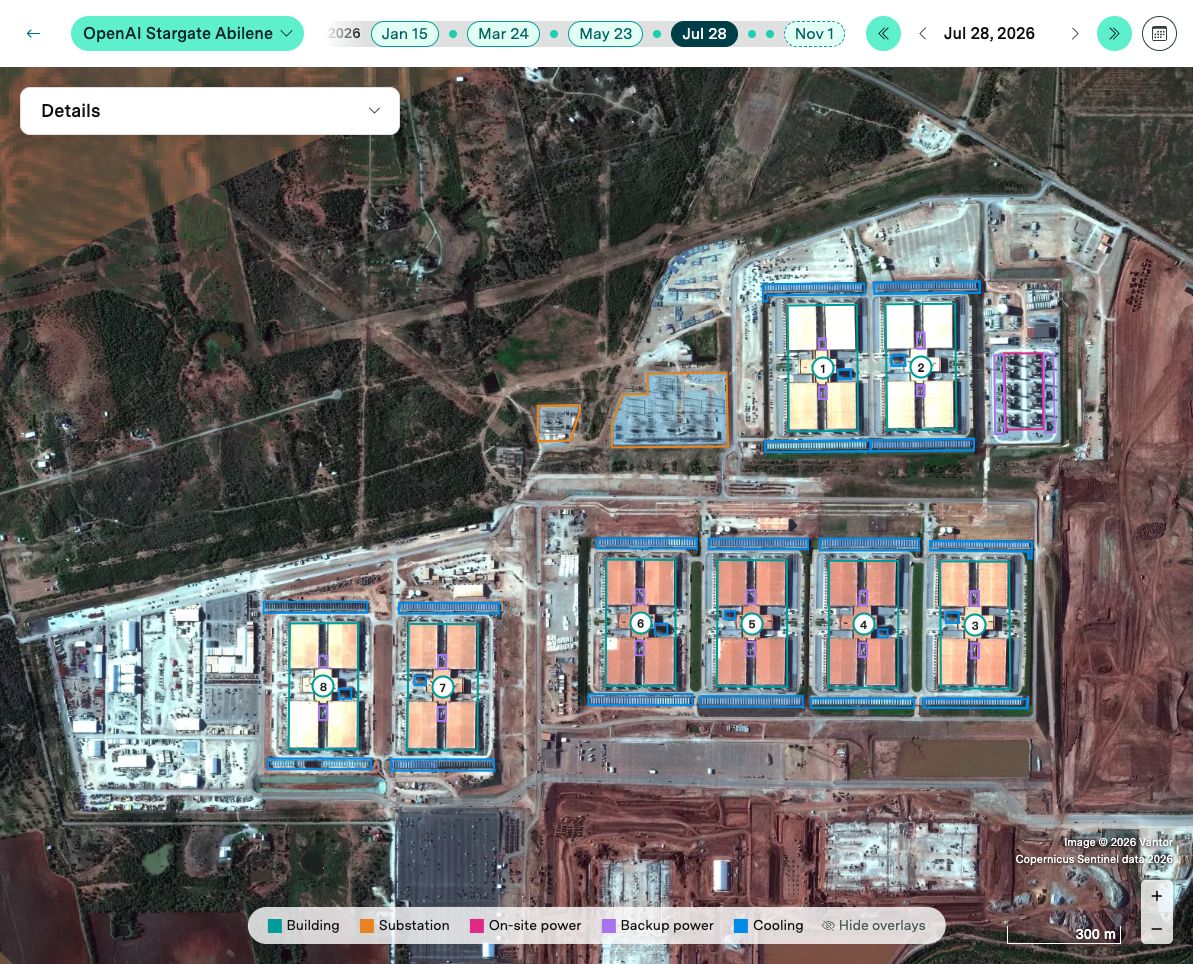
图 3:2026 年 7 月底,查看器标注 7 月 28 日,八栋建筑的屋顶均已可辨认。高分辨率影像署名 Vantor;截图保留原图标识。打开这一日期。
把影像与项目参与方的披露放在一起,交付节奏大致如下:
| 时间 | 公开证据 | 能确认什么 |
|---|---|---|
| 2024 年 6 月 | Crusoe 披露首期两栋、200 MW 以上项目开工 | 第一批机房进入建设阶段 |
| 2025 年 3 月 | Crusoe 披露另外六栋开始建设 | 扩建在首期尚未全部完成时已经推进 |
| 2025 年 10 月 | Oracle 披露为 Abilene 开发并部署定制 RoCE 网络 | 这里已涉及真实的大规模集群部署 |
| 2025 年 12 月 19 日 | Mortenson 披露新增变电站首台主变带电 | 新增供电工程开始具备分批交付条件 |
| 2026 年 3 月 10 日 | Mortenson 披露五台主变全部带电 | 新变电站的重要工程节点完成 |
| 2026 年 4 月 29 日 | OpenAI 明确表示 GPT-5.5 在 Abilene 的 OCI GB200 设施训练 | 园区已经承担过前沿模型训练 |
| 2026 年 7 月底 | Epoch 卫星影像显示八栋完整屋顶 | 八栋建筑的外部形态已基本形成 |
| 2026 年 9 月初 | Jensen 披露 GPT-6 使用约十万张以上 Grace Blackwell | 获得一次具体模型的硬件规模线索 |
来源:Crusoe、Oracle 网络公告、Mortenson 供电工程、OpenAI、Epoch。
一栋机房的交付,要经历建筑封闭、机电安装、供电与冷却调试、设备上架、网络联调、集群验收这些环节。其中一些可以并行,也可以逐厅交付。卫星影像记录外部建设进度,项目披露则补充供电、网络与模型训练的关键节点。
Epoch 的交付模型将首两栋、合计约十万 GPU 的投运时间估在 2025 年底。结合 2026 年已经发生的模型训练,这为后文考察四个月的资源窗口提供了设施层面的支撑。Epoch 交付时间线
2. 从四个数据厅,走进 72 卡机柜
航拍中的建筑很有辨识度:四块大屋顶围绕中央区域展开,看起来像四叶草。公开备案让这个外观有了内部解释。
得克萨斯州 TDLR 的 Building 2 项目登记,列出约 484,960 平方英尺的建筑面积,以及四个数据厅和行政区域。早期环境许可申请附件中的平面图,则直接画出了这个布局。TDLR Building 2 备案
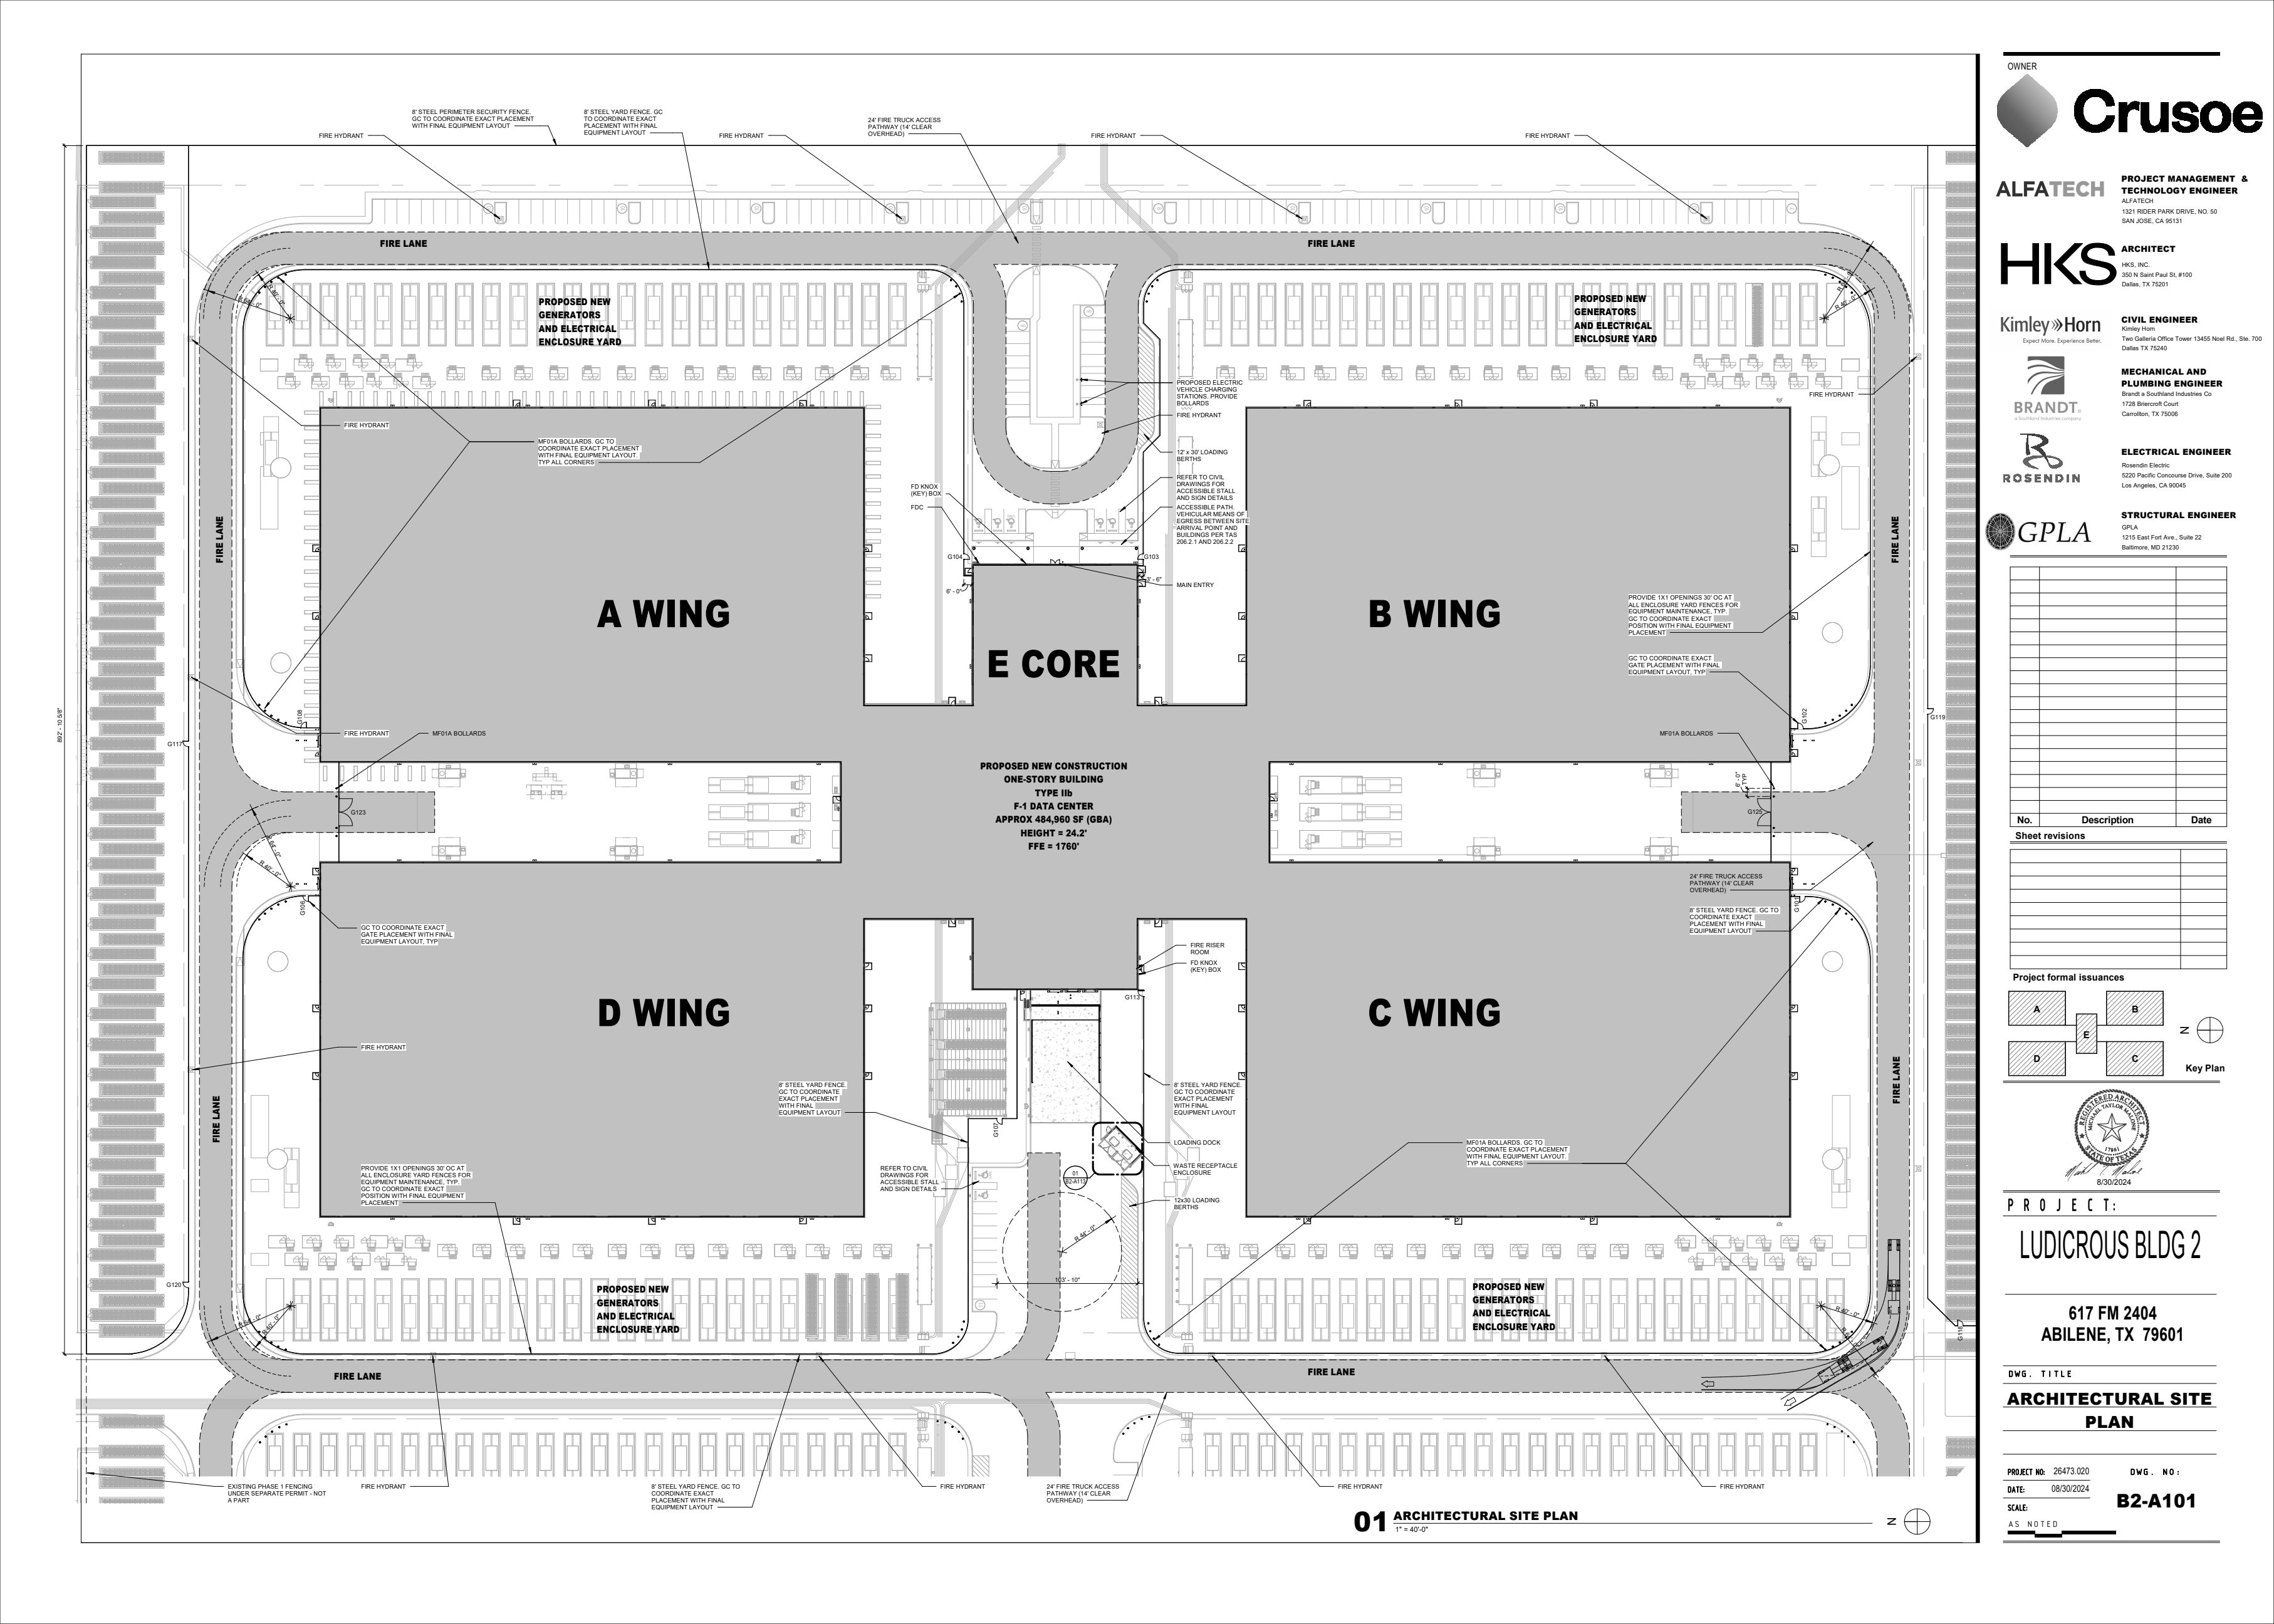
图 4:公开许可申请 PDF 第 157 页,图号 B2-A101,图面日期 2024 年 8 月 30 日。按图面方向,A、B、C、D 四个区域围绕中央 E Core 排列。公开申请文件。
结合 DPR 的介绍,可以把单栋建筑理解为:四个约 25 MW 的数据厅,合计约 100 MW IT 容量,再加上中央支撑区域和外围机电设施。 中央区域将四个厅连接起来,形成一栋完整的数据中心。DPR 建筑与机房介绍
四厅布局让供电、冷却和设备安装可以模块化推进,成熟的模块可以先行交付。
电力容量也能帮助估算每个厅的机柜数量。假设一个 NVL72 柜为 132 kW,25 MW 相当于约 189 个机柜的额定功率。实际配置还要为柜外网络、存储等设备留出电力,并满足空间与冷却需求。
机柜内的 NVLink,与机柜间的网络
NVL72 中的 72,指的是一个机柜级系统中的 72 个 GPU。NVIDIA 的 GB200 NVL72 参考设计包含 36 个 Grace CPU、18 个计算托盘,以及 9 个 NVLink 交换托盘。每个计算托盘装有 4 个 GPU。NVIDIA 系统文档
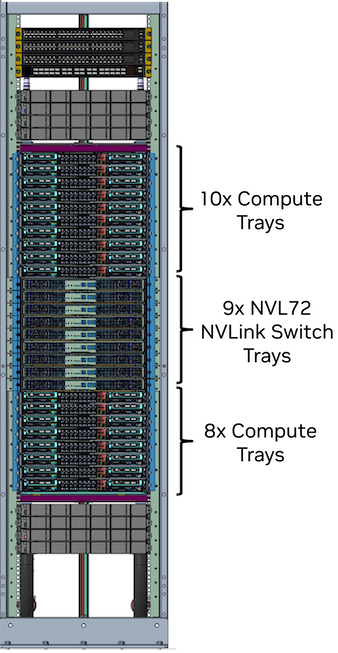
图 5:NVIDIA 官方文档中的 GB200 NVL72 参考机柜。计算托盘、NVLink 交换托盘和供电组件集成在同一机柜中。图片与说明来源。
本文将 Jensen 的数字理解为约十万张 GPU,采用 Grace Blackwell NVL72 系统,并取整为十万来计算。
于是:
100,000 \div 72 \approx 1,389\ \text{个机柜}机柜内部,NVLink 将 72 个 GPU 连接成一个高速通信域。
机柜之间,Abilene 使用 Oracle 与 OpenAI 协作开发的定制 Acceleron RoCE 网络,将多个机柜和计算模块组成更大的集群。Oracle 在 2025 年 10 月的公告中披露了这一设计。Oracle 网络公告
这种层级会影响模型的切分方式。合理的工程方向,是尽量让频繁交换大量数据的计算靠近,把其他并行任务分布到更大的网络中。张量并行、专家并行、流水线并行和数据并行的组合,则取决于模型结构与通信需求。
3. 十万张卡,对应多少建筑与电力
设施功率可以分成三层:GPU 机柜包含 GPU、CPU、交换和供电等设备;机柜之外有网络与存储;设施层承担冷却和供配电损耗。
一个方便的估算式是:
P_{\rm facility}
=\frac{G}{72}\times P_{\rm rack}
\times k_{\rm extra\ IT}\times\mathrm{PUE}
其中,PUE 是设施总用电除以 IT 用电。不同假设下,十万 GPU 的结果如下。
| 计算情景 | 单柜功率 | 柜外 IT 系数 | PUE | IT 功率 | 设施总功率 |
|---|---|---|---|---|---|
| 较低开销情景 | 120 kW | 1.10 | 1.20 | 183 MW | 220 MW |
| 较高开销情景 | 132 kW | 1.10 | 1.30 | 202 MW | 262 MW |
| Epoch 模型口径 | 132 kW | 1.14 | 1.40 | 209 MW | 293 MW |
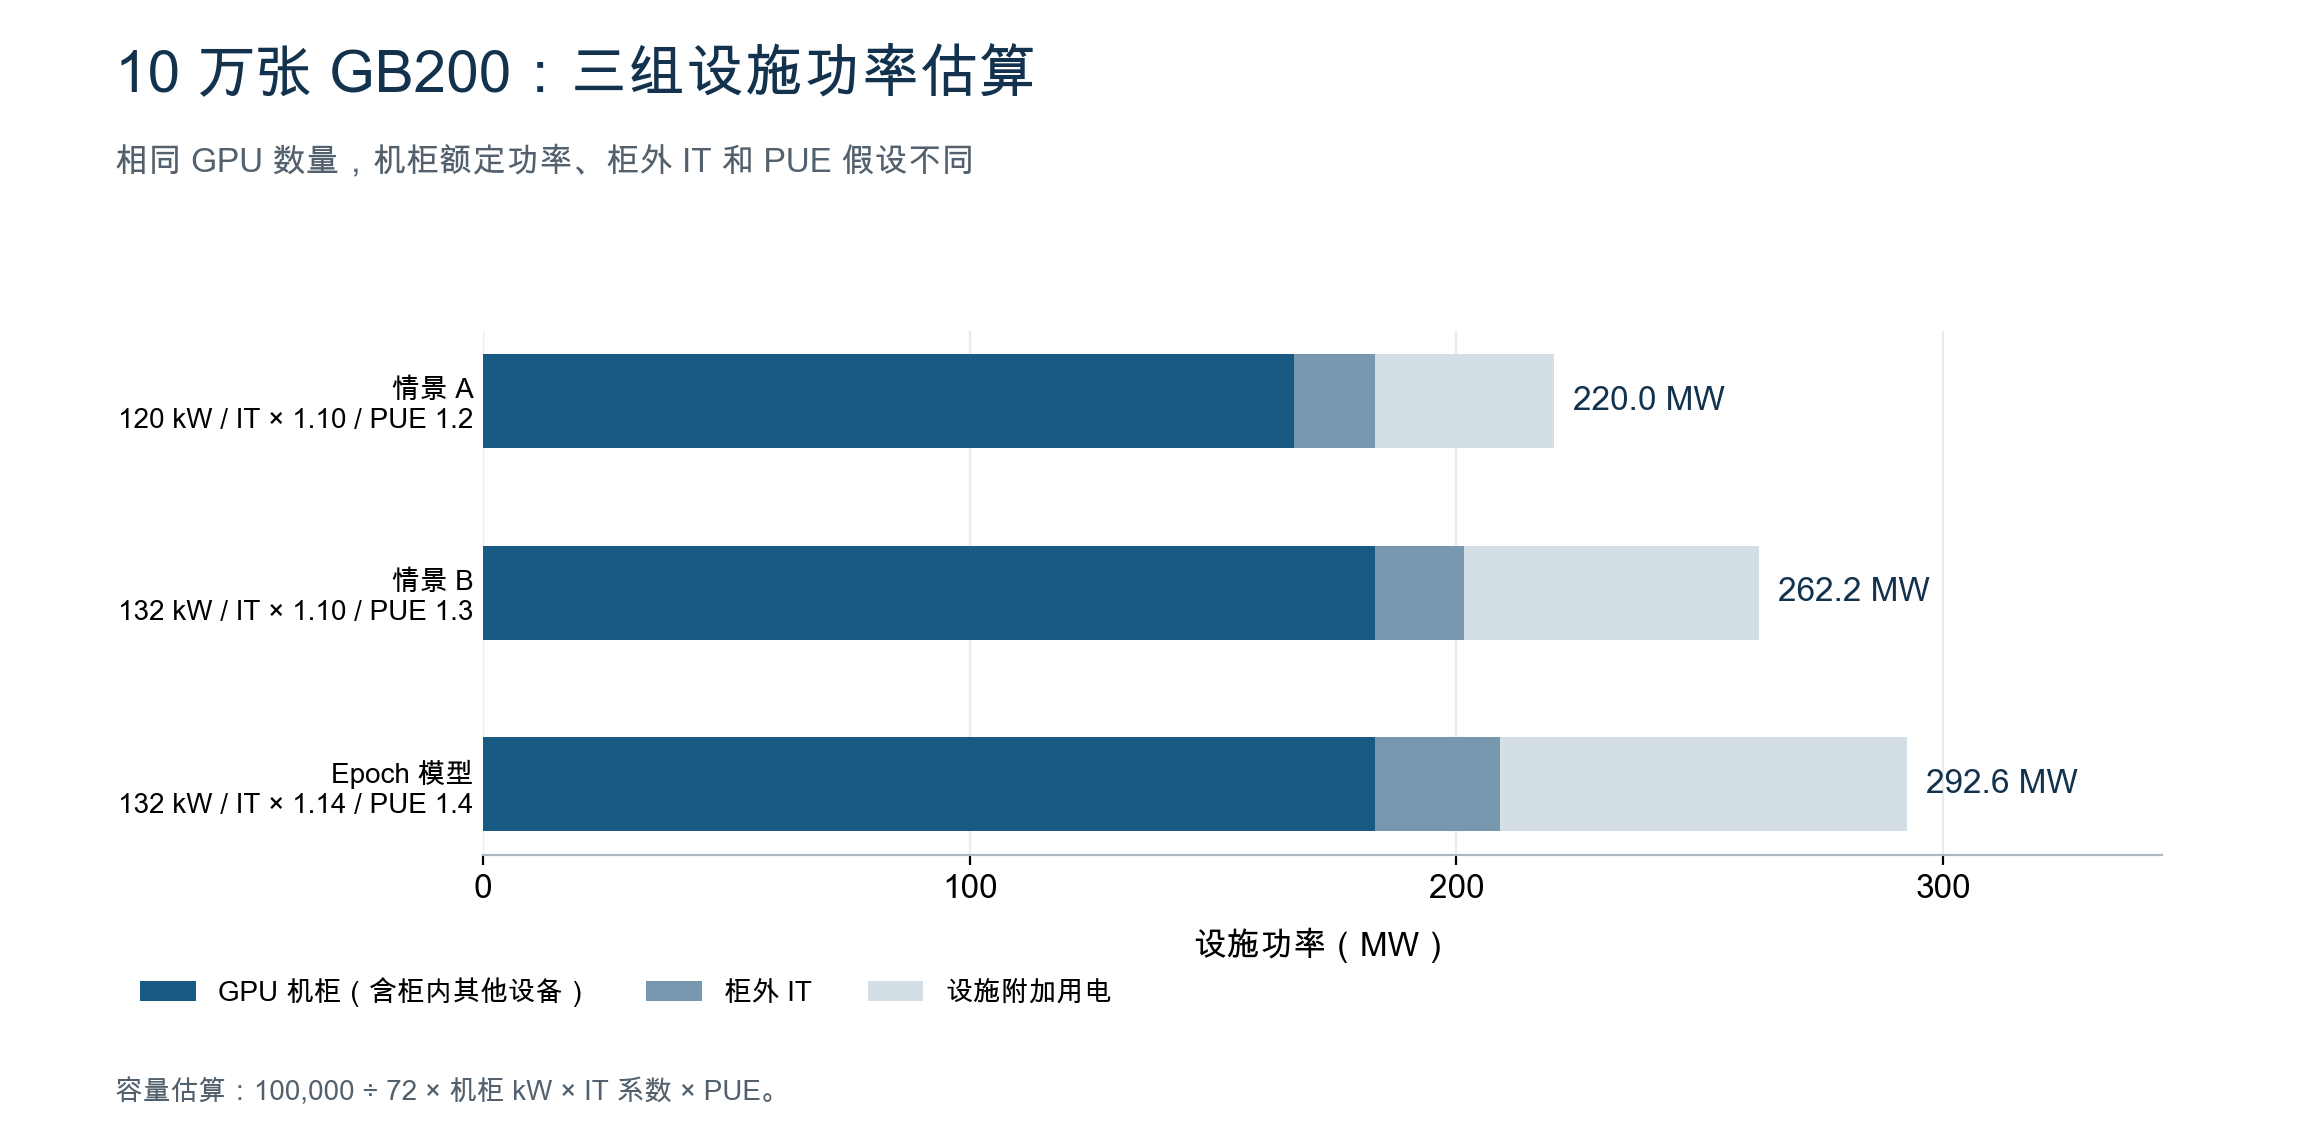
图 6:本文计算。120 kW 可参考 NVIDIA MGX 介绍;132 kW、1.14 与 1.4 来自 Epoch 计算表。
按这三组情景,十万张 GB200 对应约 0.2–0.3 GW 的设施功率。
Epoch 假设每栋楼部署 700 个 NVL72 柜,即 50,400 个 GPU。采用上表的功率系数,可以把单栋、十万卡和完整园区放在一起:
| 容量模型 | GPU 数量 | IT 功率 | 设施功率 |
|---|---|---|---|
| 一栋楼 | 50,400 | 105 MW | 147 MW |
| 两栋楼 | 100,800 | 211 MW | 295 MW |
| 八栋完整园区 | 403,200 | 843 MW | 1.18 GW |
两栋的 IT 容量接近前述四厅建筑的设计量级;八栋的设施功率则接近 Lancium 公布的 1.2 GW 电网接入容量。到这里,Jensen 的两个数字有了清晰的空间含义:十万卡约相当于两栋机房,四十万卡约相当于完整八栋园区。 Epoch 容量计算 · Lancium 接入容量
这张表描述完整部署时的容量。Epoch 在 2026 年 9 月初的目录中,将当前投运规模估为四栋、约 20.16 万 GPU,并将八栋完整规模列入第四季度预测。Epoch 园区目录
热量和电力,走的是另一条链路
航拍里建筑两侧的长条设备带,解释了机房为什么需要如此大的外围空间。Crusoe 披露,Abilene 采用芯片液冷、闭环水系统和室外风冷冷水机排热。Crusoe 冷却介绍
可以把散热过程概括成:
芯片 → 冷板与冷却液 → 换热/冷却分配环节 → 设施水回路 → 室外冷水机 → 空气。
液冷把高密度热量从芯片带出来,闭环让水循环使用,室外设备最终将热量排向空气。
电力侧,早期环境许可申请中有一张覆盖前两栋楼的流程图,画出了电网、燃气轮机和柴油设备的不同供电路径。
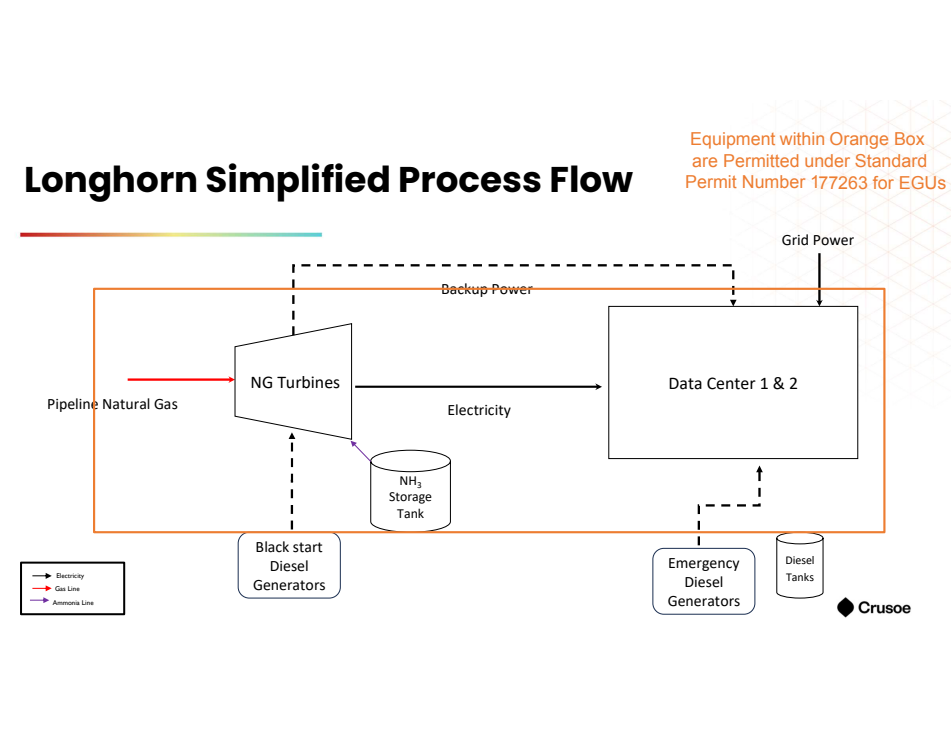
图 7:公开许可申请 PDF 第 151 页。图中区分电网、燃气发电、柴油黑启动与应急供电。公开申请文件。
这些供电路径通过主供、备用与切换安排,支持数据中心持续运行。
4. 从一次 agent 请求,估计活跃参数
要从机房走到模型,先要区分 MoE 的两种规模。活跃参数描述一个 token 经过共享模块和被选中专家时动用的参数量,直接影响主要计算开销;总参数包含完整专家池,决定模型需要存放多少权重。本文先用推理经济账估计前者,再用训练与架构线索推演后者。
Kimi K3 是一个有用的参照:官方披露 2.8T 总参数、104B 活跃参数,并公开了 API 定价和部署信息。GPT-5.5 与 GPT-5.6 Sol 则提供 OpenAI 上一代旗舰的价格参照;下文的 Sol 均指 GPT-5.6 Sol。Kimi K3 模型卡 · GPT-5.5 · GPT-5.6 Sol
先统一负载,再比较价格
取一次典型长输入 agent 调用的工作情景:100K 输入、1K 计费输出、80%–90% 输入缓存命中,以 85% 为中心。输出包含计费的思考 token;完整编程或办公任务可以包含多次调用。
2026 年 9 月 10 日国际站 Standard 费率如下,价格单位为美元/百万 token。最右一列按新增输入使用普通费率、85% 缓存命中计算。
| 模型 | 普通输入 | 缓存读取 | 缓存写入 | 输出 | 单次调用收入 |
|---|---|---|---|---|---|
| Kimi K3 | $3 | $0.30 | 按未命中输入计费 | $15 | $0.0855 |
| GPT-5.5 | $5 | $0.50 | — | $30 | $0.1475 |
| GPT-5.6 Sol | $4 | $0.40 | $5 | $20 | $0.1140 |
| GPT-6 Astra | $10 | $1 | $12.50 | $50 | $0.2850 |
来源:Kimi 官方价格、OpenAI 官方价格。Sol 当前采用至少持续到 2026 年 11 月 21 日的促销费率;GPT-5.5 的价格表列出普通输入与缓存读取。本文固定相同数值的 token 数以比较费率,实际任务还受分词和输出行为影响。
令输入为 I、输出为 O、命中率为 h,普通输入、缓存读取和输出的单价分别为 p_u、p_c、p_o,则每次调用收入为:
V=\frac{I(1-h)p_u+Ihp_c+Op_o}{10^6}Kimi 的中心账单就是:
0.015\times3+0.085\times0.3+0.001\times15
=\$0.0855
同一负载下,Astra 收入为 Kimi 的 3.33 倍、Sol 的 2.5 倍、GPT-5.5 的 1.93 倍。在 80%–90% 命中范围内,Kimi 单次收入为 $0.072–0.099,Astra 为 $0.240–0.330。
对于 agent 请求,完整账单比单看输出价格更有解释力。缓存保留了大量历史上下文的计费收入,同时减少重复 prefill;新 token 继续访问已有上下文,服务成本仍与注意力结构、缓存容量和调度有关。
Astra 的缓存写入费率是普通输入的 1.25 倍。若中心情景的全部新增输入都按缓存写入计费,单次收入升至 $0.3225,相对 Kimi 为 3.77 倍。后面的估算会同时保留这两种计费组合。缓存计费说明
收入如何对应计算规模
在相同请求分布与延迟目标下,令 s 为收入中用于服务资源的比例,a 为每单位活跃参数的服务成本。采用局部线性近似 aN_active≈sV,可得:
N_{\rm active,Astra}
\approx104B\times\frac{V_{\rm Astra}}{V_{\rm Kimi}}\times\kappa
\kappa=\frac{s_{\rm Astra}}{s_{\rm Kimi}}
\times\frac{a_{\rm Kimi}}{a_{\rm Astra}}κ 汇总了服务资源占收入的比例,以及单位活跃参数服务成本的差异。硬件采购、执行精度、批处理、专家通信、注意力结构和延迟要求,都通过它进入估计。取 κ≈1,意味着这些因素合起来大体相当:
- 新增输入按普通费率:104B × 3.33 ≈ 347B。
- 新增输入全部按缓存写入计费:104B × 3.77 ≈ 392B。
因此,本文优先考察 300B–400B 活跃参数,取 350B 为代表值。它对应普通输入情景的 κ≈1.01,或全写缓存情景的 κ≈0.89。GPT-5.5 与 Sol 的代际价格说明了 Astra 更宽的服务预算;若上一代两款模型参数量接近,其价格差异就需要由成本和效率的变化来解释。
价格到参数的换算,是这条推演中最依赖服务假设的一步。比如普通输入情景下,将 κ 从 0.75 改到 1.25,活跃规模会从 260B 移到 433B。Kimi K3 采用 KDA 与 MLA 混合注意力、MXFP4 权重和 MXFP8 激活;跨模型比较需要为这些差异保留空间。Kimi K3 架构与精度
长上下文费率也应单独处理。Astra 输入超过 272K 后,整次请求的输入及缓存费率乘 2,输出乘 1.5。按 300K 输入、1K 输出、85% 命中和普通输入计费,单次收入为 $1.485。这为更重的上下文处理提供预算;本文的活跃参数中心估计统一使用前面的 100K 情景。Astra 长上下文计费
5. 十万卡、四个月,能处理多少训练数据
确定每个 token 的活跃规模后,就可以把硬件资源换成累计训练量。本文采用以下主情景:
| 输入 | 取值 | 计算含义 |
|---|---|---|
| GPU 数量 G | 100,000 | 十万张 GB200 等效持续分配 |
| 单卡计算基准 p | 2.5 PFLOP/s | BF16 稠密运算峰值 |
| 项目资源窗口 t | 120 天 | 合计 1,200 万 GPU-days |
| 有效计算比例 η | 40% | 从硬件峰值折算到主要模型计算 |
| 主预训练份额 f | 60% | 项目有效计算中分配给目标主预训练的份额 |
NVIDIA 给出的 NVL72 BF16 稀疏峰值为 360 PFLOP/s,取稠密运算的一半、再除以 72 个 GPU,得到单卡 2.5 PFLOP/s。本文用这一精度口径作为计算基准。NVIDIA GB200 NVL72 规格
120 天描述四个月的项目资源窗口,60% 则描述其中目标主预训练获得的份额,等效于全量集群分配 72 天。剩余份额用于其他实验与训练阶段。40% 的有效比例处理执行、通信、重计算和停机等开销,统一折算到下文的主要模型 FLOPs 口径。这两个比例分别回答“资源如何分配”和“分配到的资源完成多少有效计算”。
四个月的窗口与前述机房交付时间线相容;对某个模型实际分配多少 GPU-days,本文采用表中的情景输入。
主预训练计算预算为:
\begin{aligned}
C_{\rm pre}
&=G\times p\times(t\times86,400)\times\eta\times f\\
&=100,000\times2.5\times10^{15}
\times(120\times86,400)\times0.40\times0.60\\
&=\boxed{6.2208\times10^{26}\ \mathrm{FLOPs}}
\end{aligned}
对应的项目有效计算总量为 1.0368 × 10²⁷ FLOPs,其中 60% 进入这次主预训练。
6ND 怎样用于 MoE 训练
对主要参数矩阵乘法,一次前向传播约需每参数、每 token 两次浮点运算,反向传播约需前向的两倍,合计得到常用的近似:
C_{\rm pre}\approx6N_{\rm active}DMoE 的每个 token 经过共享模块与被路由选中的专家,所以这里使用 平均活跃参数 N_active。完整专家池决定可选择的容量,实际选中的计算路径决定当次主要运算量。注意力等额外运算及执行开销会影响前述有效比例的取值。MoE 联合缩放研究
D 是主预训练阶段累计处理的逻辑 token 数。 重复训练的数据按处理遍次累计,合成数据也计入;模型并行切分的各部分共同处理一个 token,全局累计时计一次。因此,300T 描述累计训练量,其信息含量还取决于数据质量、重复率和混合配方。
代入 350B 活跃参数:
D=\frac{6.2208\times10^{26}}{6\times350\times10^9}
\approx\boxed{296.2T\ \text{token}}
同样预算下,300B 活跃参数对应 345.6T,400B 对应 259.2T。活跃规模越大,每个 token 越贵,能够累计处理的数据越少。本文用 约 300T 概括中心情景。
这也解释了为什么训练经济性需要把上线后的推理一起考虑。若模型会承担大量推理请求,保持较小的活跃规模、在训练阶段投入更多数据,可能获得更好的全生命周期成本;关于训练与推理联合优化的研究讨论了这一方向。Beyond Chinchilla-Optimal
6. 从累计数据,推演完整专家池
训练预算与活跃规模先给出 D。接下来需要一项关于数据配方的假设,才能推到总参数。定义两个便于比较的比例:
r=\frac{N_{\rm total}}{N_{\rm active}},
\qquad
\tau=\frac{D}{N_{\rm total}}
r 描述完整模型相对活跃路径的规模;τ 描述累计训练 token 与总参数的比例。几份公开资料提供了参照:
| 开放 MoE 模型 | 总参数 | 活跃参数 | r:总量/活跃 | 累计预训练 token | τ:token/总参数 |
|---|---|---|---|---|---|
| Kimi K3 | 2.8T | 104B | 26.9 | 模型卡未列出 | — |
| DeepSeek V4 Pro | 1.6T | 49B | 32.7 | 超过 32T | 超过 20 |
| Kimi K2 | 1T | 32B | 31.3 | 15.5T | 15.5 |
| DeepSeek V3 | 0.671T | 37B | 18.1 | 14.8T | 22.1 |
来源:Kimi K3 模型卡、DeepSeek V4 Pro 模型卡、Kimi K2 技术报告、DeepSeek V3 技术报告。V4 Pro 的数据量保留官方“超过”的下界口径。
对于更大的 Astra,本文取 τ≈30,为完整专家池安排更充分的累计训练量。这是基于开放模型配方提出的外推选择。在相同预算与活跃规模下,提高 τ 会把总参数往下推:每单位总参数要求更多训练数据,可支持的专家池就随之缩小。
于是,350B 的中心情景得到:
N_{\rm total}=\frac{D}{\tau}
=\frac{296.2T}{30}
\approx\boxed{9.87T}
再看它的架构比例:
r=\frac{9.87T}{0.35T}\approx28.2这个比例落在 Kimi K3 的 26.9 与 DeepSeek V4 Pro 的 32.7 之间。也就是说,约 10T 总参数、350B 活跃参数、300T 累计训练 token 可以组成一套相容的情景,同时保持接近这两个 T 级开放模型的全模型激活比例。
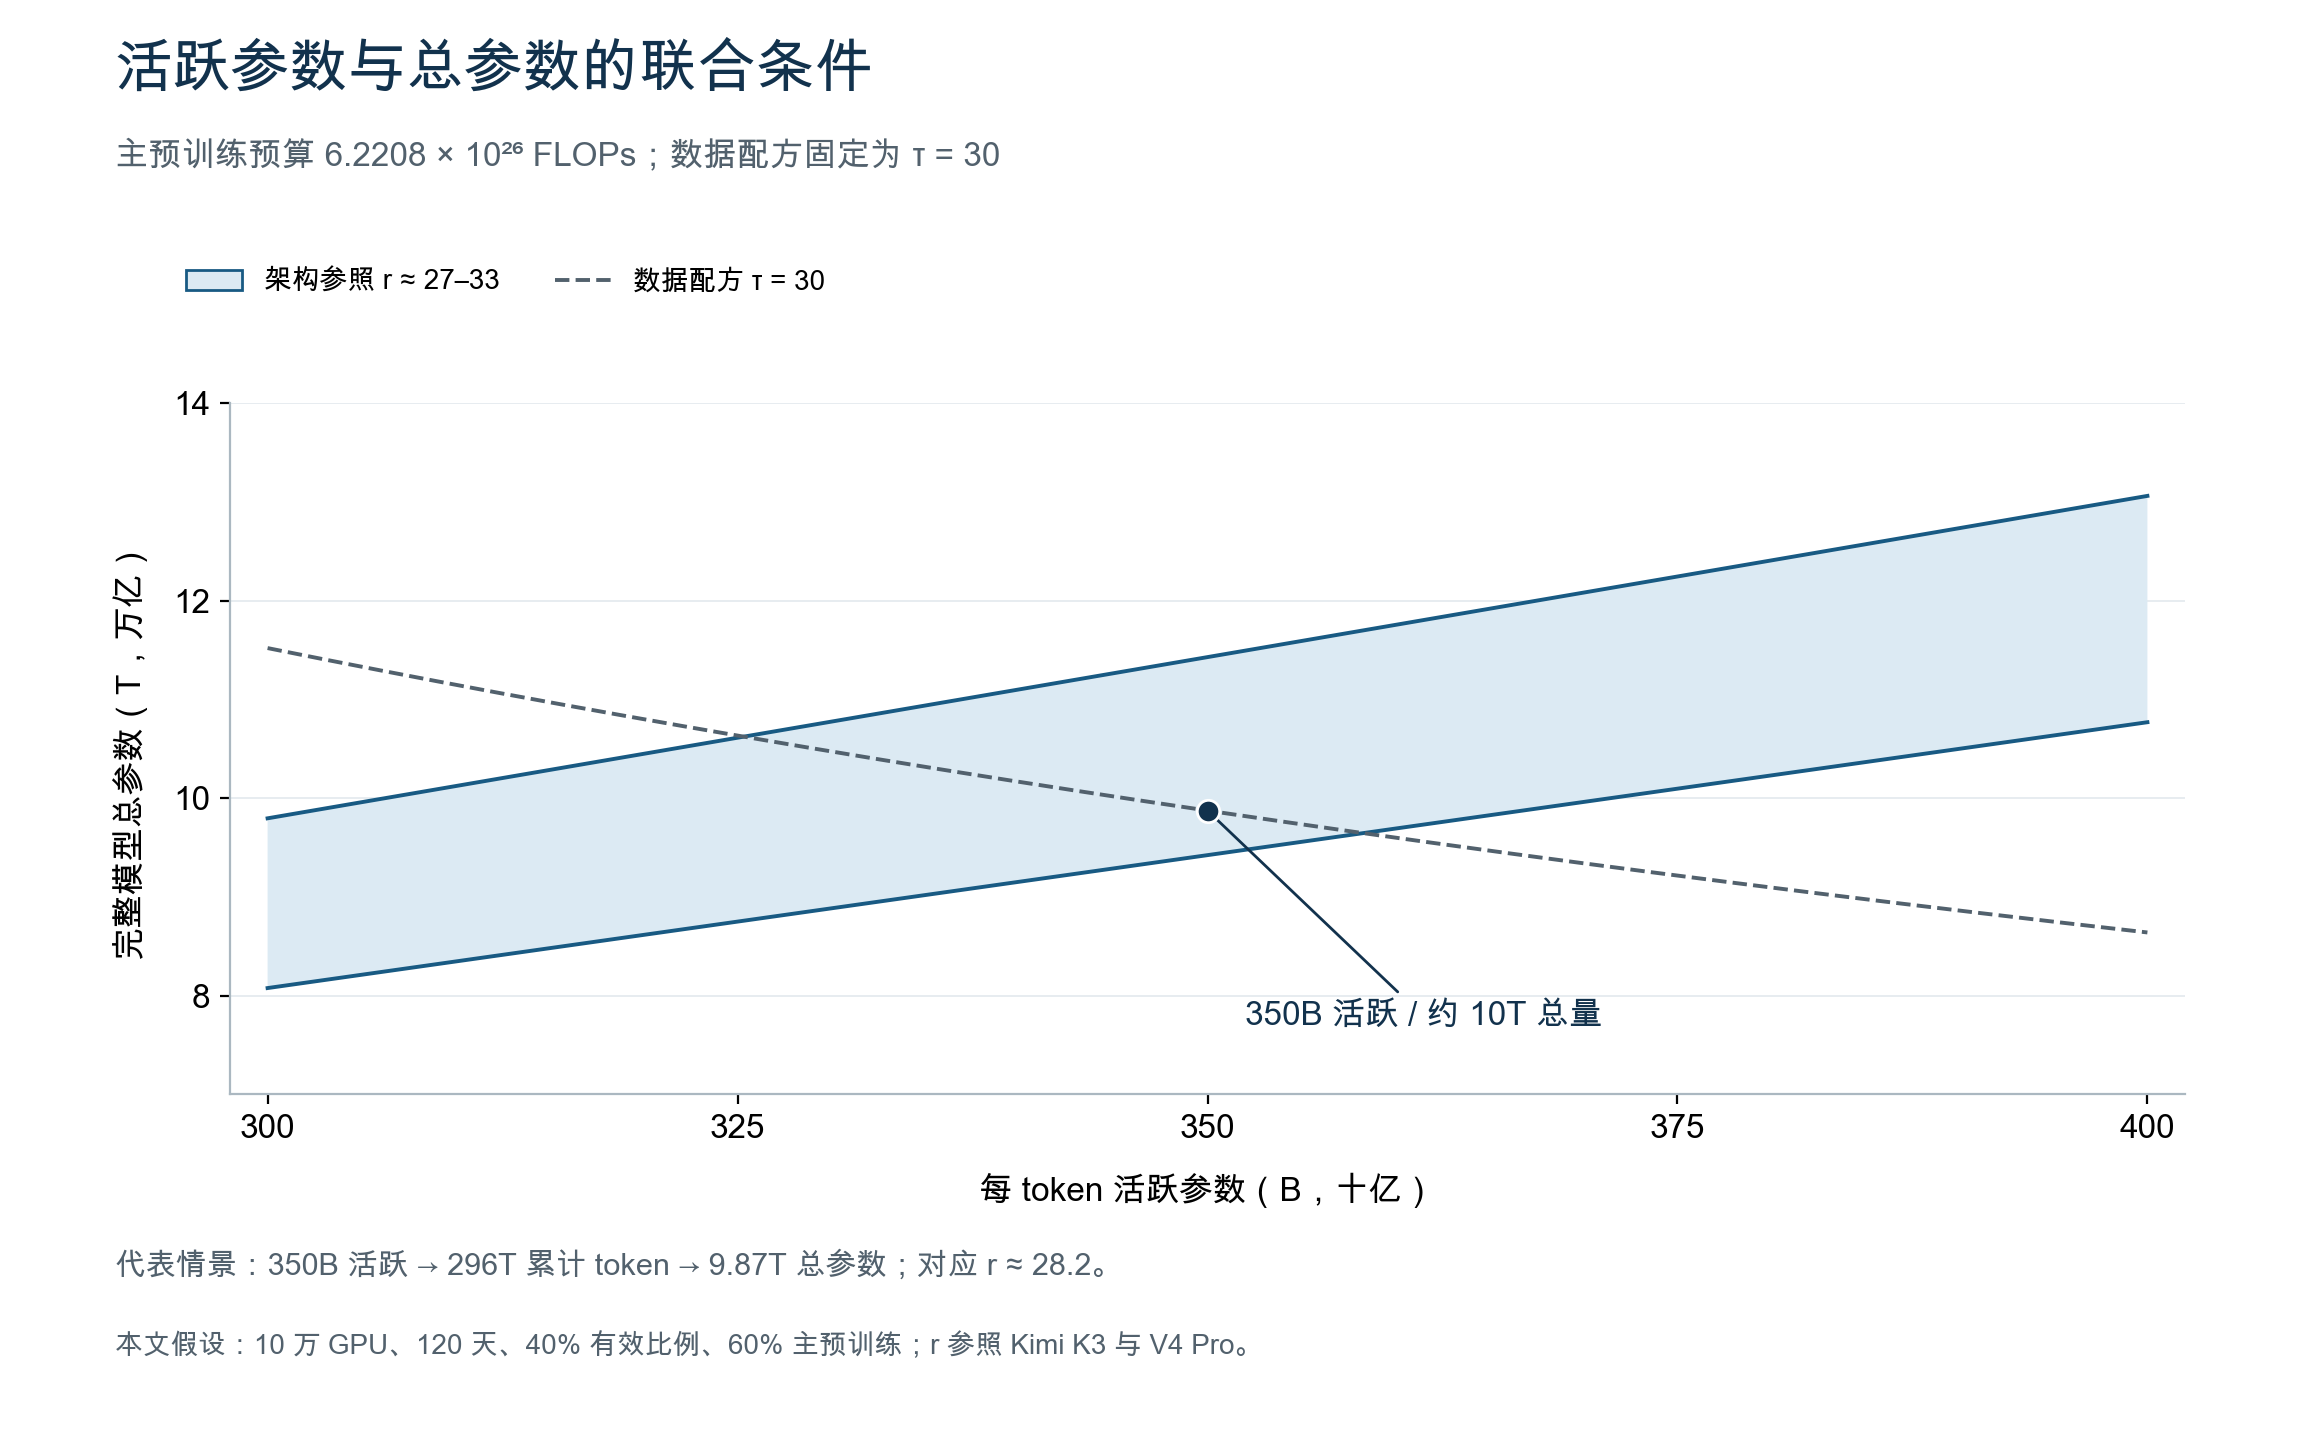
图 8:蓝色区域按 Kimi K3 与 V4 Pro 的 r≈27–33 绘制;虚线按主预训练预算 6.2208 × 10²⁶ FLOPs、τ=30 计算。圆点对应 350B 活跃、9.87T 总参数。代表点展示了两组条件在约 10T 附近的相容性。逐点计算数据。
这里还可以做一次训练量对照。累计 token 除以活跃参数,Kimi K2 约为 484,V4 Pro 超过 653,本情景约为 846。本情景的这一比值约为 Kimi K2 的 1.75 倍,V4 Pro 披露的下界则提供了同量级参照。接近 300T 的绝对训练量,仍然需要足够好的数据生产、筛选、重复利用与混合策略。
τ=30 是整模型的数据配方比值。对具体专家,它能看到多少 token,还取决于专家数量、每次路由选择数量与负载分布。现代 MoE 的缩放研究会联合考虑总参数、活跃参数、数据量和路由结构,公开模型在这里提供的是架构与配方的比较基准。MoE 多变量缩放研究
7. 约 10T 的模型,怎样装进推理系统
现在可以回到硬件,检查这个规模的部署空间。将完整模型按原始 4 bit 权重估算,10T 参数约占 5 TB。三种系统的容量差异很直观:
| 推理系统 | GPU 数量 | 合计 HBM | 10T 原始 4 bit 权重所需容量 |
|---|---|---|---|
| 八卡 B200 | 8 | 1.44 TB | 5 TB |
| 八卡 B300 | 8 | 2.304 TB | 5 TB |
| GB200 NVL72 | 72 | 13.4 TB | 5 TB |
采用十进制 TB;4 bit 为本文部署假设,量化元数据另占容量。来源:NVIDIA HGX 规格、GB200 NVL72 规格。
完整权重在八卡系统上需要额外存储、卸载或跨节点方案。一个 NVL72 则在存放 5 TB 原始权重后,还留有约 8.4 TB,用于量化元数据、上下文状态、运行缓冲及并行冗余。如果采用 8 bit,原始权重约占 10 TB,生产并发的容量余量会明显收紧。
这让“一柜 NVL72 承载一个完整生产副本”成为值得考察的部署情景。它的最终经济性,还要由长上下文下的实际吞吐和延迟共同决定。
容量之外,还需要赚回多少吞吐
Fixstars 提供了 Kimi K3 的一个八卡实测点:8 张 B300、8192 输入、1024 输出、并发 20,采用投机解码,整机约 515.8 输出 token/s。这个测点证明了相应配置下的运行表现;本文的 100K agent 负载会增加上下文与 prefill 压力,需要对应的服务测量。Fixstars Kimi K3 测试
经济账可以先给出一个待验证的吞吐目标。仍取 100K 输入、1K 输出、85% 缓存命中、新增输入按普通费率;每百万计费输出连同对应输入,Kimi 收入为 $85.5,Astra 为 $285。
假设系统每小时资源成本为 H,全天有 70% 的时间达到所选服务负载,希望收入支付资源成本后留下 30%,则服务期间所需的整套系统合计计费输出吞吐 Q为:
Q=\frac{H\times10^6}{3600\times0.70\times(1-0.30)\times R}其中 R 是每百万输出及对应输入的收入;Q 的单位是输出 token/s。按几组显式成本情景计算:
| 服务情景 | 假设资源成本 H | 所需合计输出吞吐 Q |
|---|---|---|
| Kimi K3,八卡 B300 | $80/小时 | 530 token/s |
| Astra,一柜 NVL72 | $360/小时 | 716 token/s |
| Astra,一柜 NVL72 | $720/小时 | 1,432 token/s |
资源成本是用于比较的情景输入;30% 为扣除这项资源成本后的收入结余比例。Q 汇总全部并发请求,与单用户看到的生成速度分开计量。
Kimi 的门槛已经接近前述较短上下文实测点,因此长输入下的缓存复用、prefill 效率和调度很关键。Astra 的较高请求收入则为一柜系统提供了更大的服务预算。对于 350B 活跃、10T 总量的假设,下一项有价值的检验,就是能否在目标延迟内达到这个吞吐量级。
8. 这条推演最终落在哪里
从 Jensen 的一句话出发,我们得到了一组可以互相衔接的工程情景:
| 关键环节 | 本文采用的中心情景 |
|---|---|
| 训练设施 | 十万张 GB200,约 1,400 个 NVL72 机柜;约两栋机房、0.2–0.3 GW |
| 推理经济参照 | 100K 输入、1K 输出、85% 缓存命中;Kimi K3 已知参数与 OpenAI 代际价格 |
| 活跃参数 | 约 350B,优先考察 300B–400B |
| 项目资源与分配 | 120 天、40% 有效计算比例、60% 主预训练份额 |
| 主预训练计算 | 6.2208 × 10²⁶ FLOPs |
| 累计主预训练 token | 约 300T,350B 下计算值 296.2T |
| 数据与架构比例 | τ≈30;对应 r≈28,接近 Kimi K3 与 V4 Pro |
| 总参数 | 约 10T,严格 τ=30 时计算值 9.87T |
| 推理部署 | 一柜 NVL72 作为完整副本的候选,原始 4 bit 权重约 5 TB |
公开资料对机房、GPU 规格与开放模型给出了直接参照。模型参数的猜测,则主要依赖两处迁移:把服务价格与成本关系迁移到 Astra,以及把开放 MoE 的数据配方迁移到更大的专家池。 120 天与 60% 份额确定了这组推演所使用的资源预算。真实的服务成本、GPU-days 分配和累计训练数据,会分别校准这些位置。
本文因此选择用 “350B 活跃、10T 总量、300T 累计 token” 表达中心猜测。它对应的方向是:每个 token 的计算规模扩大到 Kimi K3 的三倍多,完整专家池扩展到约十万亿参数,同时投入更多累计数据,让这条活跃路径获得更充分的训练。
Jensen 随后提到的四十万 GPU,与 Abilene 八栋园区的容量处在相同量级。如果同类可用资源从十万卡扩到四十万卡,模型团队就有更大的空间分配给专家容量、训练数据、强化学习、实验速度和线上推理。机房决定了这些选择的资源边界,模型与产品的经济性决定资源最终流向哪里。
资料与复算附件
- Epoch 园区目录与交付时间线及原始容量计算表;公开环境许可申请 PDF,图纸引用电子文件第 151、157 页。
- 统一情景输入、功率情景及图片来源清单。
- Agent 请求账单、服务吞吐门槛、活跃参数敏感性及代际价格归一化。
- 模型与显存情景及推理经济账完整结果与来源。
- 训练预算逐步换算、累计 token 情景、开放模型数据配方与各总参数规模的数据需求。
- 总参数图表数据及条件交集与敏感性。附件包含固定 r 与 τ 后的精确交集,以及改变资源份额和数据配方的结果。
- 经济账复算脚本、训练复算脚本、绘图脚本及绘图依赖。在解压后的文章目录中,依次运行三个 Python 脚本即可复算数据并生成分析图;照片、卫星影像、图纸与产品图的出处见各图注。